11. oktober 2026
AI-nyheder Automatisering & AI
Lokal AI og GDPR: dansk forskning kan gøre en reel forskel for virksomheder
Danske Sevren får adgang til supercomputeren Gefion og arbejder på at gøre AI-modeller mere effektive. Det interessante er ikke prisen, men hvad det kan betyde for virksomheder, der vil bruge AI på egne data uden at miste kontrollen med dem.
Det er nemt at bygge en imponerende AI-demo med ti opdigtede kundemails. Det bliver straks mere interessant, når systemet skal læse ti tusind rigtige.
For så følger der navne, priser, aftaler, ordrenumre, personoplysninger og interne beskeder med. Og pludselig handler AI-projektet ikke kun om, hvor godt modellen svarer. Det handler også om, hvor oplysningerne bliver behandlet, hvem der kan se dem, og hvad systemet får lov til at gøre med dem.
Derfor synes jeg, at en ny dansk AI-aftale fortjener opmærksomhed. Ikke fordi den løser alle problemerne. Men fordi den peger på en retning, der kan få betydning for langt flere virksomheder end dem, der selv udvikler AI.
Hvad er der sket hos Sevren og DCAI?
Den 9. september 2026 offentliggjorde Danish Centre for AI Innovation (DCAI) en aftale med det danske AI-laboratorium Sevren. Sevren får adgang til den danske AI-supercomputer Gefion, herunder NVIDIA DGX B300-systemer med Blackwell Ultra-grafikprocessorer.
Sevren udspringer af AI-arbejdet i den danske fintechvirksomhed Monthio. Laboratoriet blev lanceret den 26. august 2026 og arbejder med teknologier, der skal gøre avancerede modeller mindre krævende at udvikle og køre.
To navne er centrale:
HEIMR
Sevrens arbejde med mere effektive modelarkitekturer. Det er et alternativ til den mekanisme, der afgør, hvilke dele af en tekst modellen skal give opmærksomhed. Målet er mindre brug af regnekraft og hukommelse — og at kunne køre krævende opgaver med meget lang kontekst på mindre udstyr.
Faberon
Et forsknings- og optimeringsværktøj, der skal understøtte udviklingen og delingen af nye metoder, så europæiske AI-udviklere får mere ud af begrænsede regneressourcer.
Sevren oplyser, at tidlige forsøg på Gefion har givet væsentlige effektivitetsforbedringer på ombyggede, åbne modeller uden tilsvarende fald i den målte kvalitet. Det er lovende, men foreløbige resultater. Det er ikke dokumentation for, at enhver stor AI-model nu kan køre billigt på en almindelig computer.
Fra supercomputer til lokal AI — hvorfor hænger det sammen?
Gefion er en stor forsknings- og udviklingsplatform. Den skal ikke forveksles med en lokal AI-server hos en almindelig virksomhed. Forbindelsen ligger i, hvad der bliver udviklet på den.
I september offentliggjorde Sevren eksempelvis Heimr 570M, en eksperimentel sprogmodel målrettet telefoner og bærbare computere. Modellen har cirka 2,7 milliarder parametre i alt, men bruger omkring 570 millioner aktivt for hvert tekststykke, den behandler.
I Sevrens egne målinger kunne den generere tekst to til otte gange hurtigere end udvalgte sammenlignelige, små åbne modeller, når konteksten var lang. Det er et konkret teknisk resultat målt under bestemte forhold, ikke et løfte om tilsvarende forbedringer ved alle opgaver. Modellen er stadig eksperimentel, og hastighed siger ikke alene noget om, hvor pålidelig den er til for eksempel kundeservice, jura eller økonomi.
Men retningen er interessant: Hvis flere brugbare AI-opgaver kan løses med mindre hardware, bliver det mere realistisk at køre dele af løsningen på virksomhedens egne maskiner eller i et miljø, virksomheden selv kontrollerer. Og så kommer datasiden for alvor ind i billedet.
Det centrale spørgsmål er ikke kun, hvilken model I vælger
Forestil dig en virksomhed, der vil bruge AI til at sortere indgående mails, finde relevante oplysninger i sit ERP-system og klargøre svar til kunder. Der er flere måder at bygge sådan en løsning på.
Almindelig cloudtjeneste
Materialet sendes normalt til leverandørens system. Det behøver ikke være et problem. En seriøs erhvervsløsning kan have passende aftaler, sikkerhedsforanstaltninger og klare vilkår for brug og opbevaring.
Afgrænset, hostet løsning
Mere kontrol med miljøet, med hvem der har adgang, og med hvor behandlingen foregår. Men leverandører, underdatabehandlere og eventuelle overførsler skal stadig undersøges.
Korrekt opsat lokal model
Selve AI-behandlingen foregår på virksomhedens egne servere, uden at indholdet sendes videre til en ekstern AI-leverandør. Interessant ved fortrolige aftaler og forretningskritisk viden.
Men lokal drift er ikke automatisk bedst. En lokal server med dårlig adgangsstyring og manglende opdateringer kan være et ringere valg end en veldrevet cloudløsning med gode databehandlingsvilkår.
Det afgørende er ikke, om der står en server i Danmark. Det er, om virksomheden har styr på hele dataforløbet.
Lokal AI gør ikke virksomheden GDPR-compliant
Det er værd at slå fast, for det er her, markedsføringen let bliver for enkel.
En model, der kører i jeres eget serverrum, fritager jer ikke for GDPR. Personoplysninger skal stadig behandles til et lovligt formål, på et gyldigt behandlingsgrundlag og med passende sikkerhed. I skal begrænse adgangen og undgå at behandle flere oplysninger, end opgaven kræver.
Bruger I eksterne leverandører som databehandlere, skal aftaler og ansvar være på plads. Og ved behandlinger med høj risiko kan der være krav om en konsekvensanalyse, før systemet sættes i drift.
Det følger blandt andet af GDPR's regler om dataminimering, behandlingsgrundlag, databehandlere og sikkerhed. Det Europæiske Databeskyttelsesråd har desuden understreget, at spørgsmål om AI-modeller og personoplysninger skal vurderes konkret. At kalde en model »anonym« gør den ikke nødvendigvis anonym.
Det er heller ikke nok at slå modeltræning på egne data fra. Oplysninger kan stadig indgå i forespørgsler, logfiler, søgeindekser, sikkerhedskopier og integrationer.
Og hvis der ikke er nogen politik, hvilket der ofte ikke er, så betyder det ikke, at alt er tilladt. Det betyder, at ingen har taget stilling.
Fra min bog AI i hverdagen, kapitel 25 om privatliv og sikkerhed, side 240.
Den pointe gælder i høj grad, når AI flytter fra den enkelte medarbejders chatvindue og ind i virksomhedens systemer.
Et konkret eksempel: fra kundemail til forslag i ERP-systemet
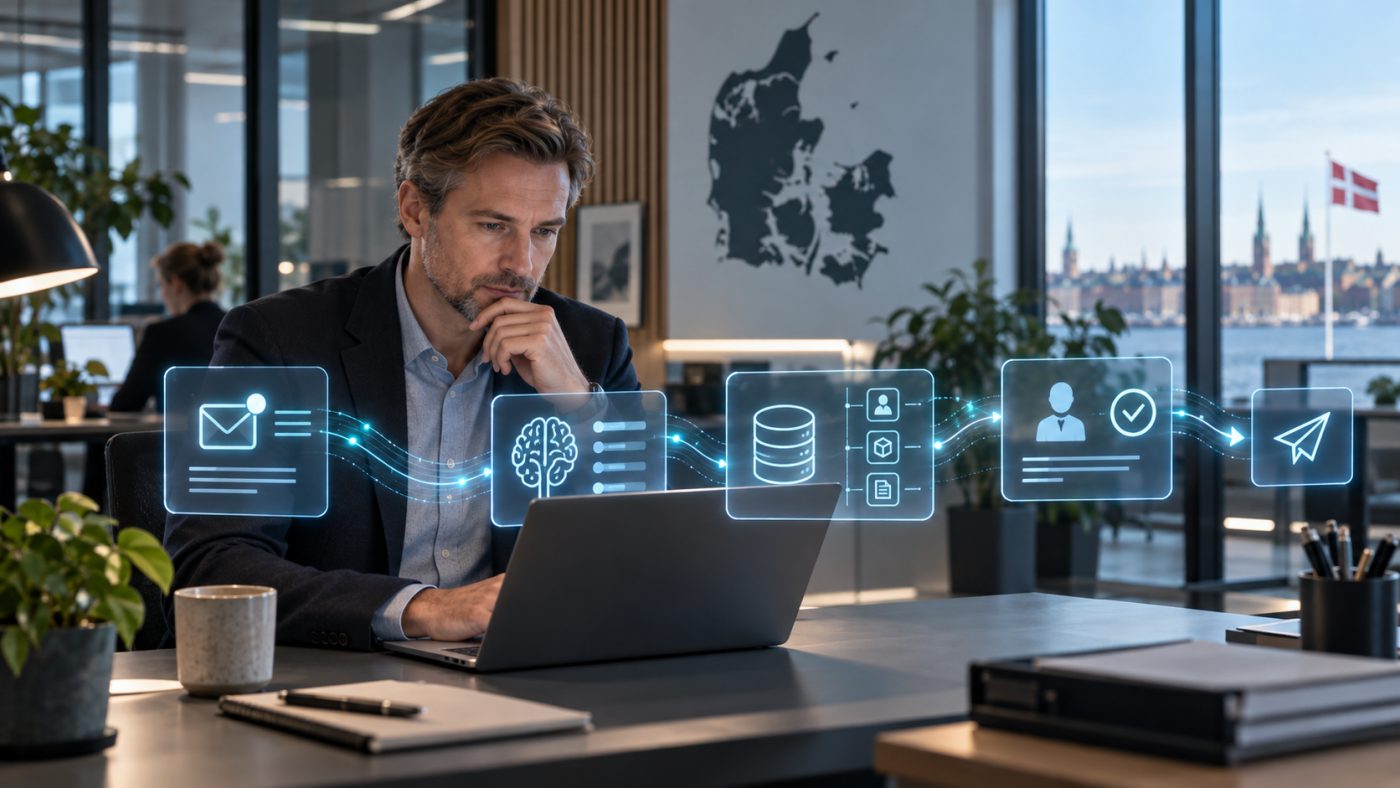
Tag en helt almindelig arbejdsgang. En kunde skriver, at en levering mangler. Mailen indeholder navn, kontaktoplysninger, ordrenummer og måske en længere mailtråd.
En AI-løsning skal ikke nødvendigvis have adgang til hele mailboksen, alle kundekonti og alle funktioner i ERP-systemet for at hjælpe.
Den kan bygges, så den først identificerer den relevante henvendelse, får adgang til de nødvendige oplysninger og bruger en sprogmodel til at klassificere sagen. Et afgrænset opslag i ERP-systemet kan derefter hente ordrestatus. Til sidst udarbejder systemet et forslag til svar, som en medarbejder gennemgår og godkender.
Nogle dele kan klares med almindelig automatisering. Andre kan have gavn af en lille lokal model. Og enkelte vanskelige sager kan kræve en stærkere model eller en medarbejder fra starten. Det er ikke et eksempel på en færdig Sevren-løsning. Det er et eksempel på, hvorfor mere effektive modeller kan få praktisk betydning.
Et sikkerhedspunkt, der er værd at forstå
En mail er data fra en ekstern afsender, ikke en instruktion fra virksomhedens ledelse. En AI-agent kan i visse tilfælde narres til at følge instruktioner, der er gemt i det materiale, den læser.
Derfor bør en model, der læser mails, ikke samtidig have fri adgang til at sende beskeder, ændre kundedata eller hente fortrolige oplysninger uden kontrol. Lad modellen hjælpe med vurderingen. Giv den ikke flere rettigheder, end opgaven kræver. Jeg har skrevet mere om, hvad der adskiller en rigtig agent fra et workflow, i artiklen om AI-agenter.
Er en mindre model også en billigere løsning?
Ikke nødvendigvis.
Prisen på selve AI-kørslen er kun én del af regnestykket. En virksomhed skal også betale for integrationer, opsætning, serverdrift, opdateringer, overvågning, fejlhåndtering og den menneskelige kontrol, der stadig er nødvendig.
En lille model, som håndterer 80 procent af de simple sager godt, kan være en glimrende investering, hvis resten bliver sendt videre på en fornuftig måde. Den samme model kan være en dyr fejl, hvis medarbejderne skal bruge mere tid på at rette dens svar, end de tidligere brugte på at løse opgaven.
Mål pris pr. korrekt løst arbejdsgang — ikke pris pr. million tokens eller placeringen på en modelrangliste. Det er der, teknisk effektivitet bliver til reel forretningsværdi. Men først når kvaliteten er testet på de opgaver, virksomheden faktisk har.
Sådan ville jeg gribe det an i en virksomhed
- Vælg én konkret arbejdsgang. Eksempelvis mailsortering, søgning i interne vejledninger eller udtræk af oplysninger fra bilag. Ikke »vi skal have AI overalt«.
- Tegn dataforløbet. Hvilke oplysninger kommer ind, hvor behandles de, hvilke systemer skal kontaktes, og hvad bliver gemt undervejs?
- Afklar rammerne, før I tester med rigtige data. Formål, behandlingsgrundlag, fortrolighed, leverandøraftaler og adgangsstyring skal tænkes ind fra starten.
- Test med repræsentative opgaver. Sammenlign en lokal model, en eventuelt godkendt cloudløsning og almindelig automatisering. Mål fejl, svartid, menneskelig efterkontrol og de samlede omkostninger.
- Giv begrænset adgang og behold kontrollen. Start med læseadgang, log relevante handlinger, og kræv godkendelse, før systemet sender noget ud eller ændrer forretningskritiske data.
Nogle virksomheder vil ende med en lokal løsning. Andre med en erhvervsaftale hos en cloudleverandør. Mange vil få mest ud af en kombination. Valget bør afgøres af opgaven, dataene og økonomien — ikke af, hvad der lyder mest avanceret.
Det er derfor, jeg følger Sevren
Der bliver talt meget om, hvem der har den største model, flest parametre og den bedste score på den seneste test. Det er relevant forskning. Men det er ikke nødvendigvis det, en dansk virksomhed har brug for at vide, når den skal have styr på sin ordreindbakke eller automatisere en tilbagevendende administrativ opgave.
Hvis forskning som Sevrens fører til modeller, der kan løse flere opgaver på mindre og mere kontrollerbar hardware, bliver der åbnet for andre valg end i dag. Det er endnu ikke bevist, hvor stor forskellen bliver i almindelige virksomhedsløsninger. Og GDPR-ansvaret forsvinder ikke, uanset hvor effektiv modellen bliver.
Men muligheden er værd at følge: mere nyttig AI tættere på de data, den skal arbejde med. For mig er succeskriteriet ikke, hvor imponerende en model er. Det er, om den løser en rigtig opgave sikkert, pålideligt og til en pris, der giver mening.
Har I en arbejdsgang, hvor AI kunne hjælpe — men dataene gør jer usikre? Jeg hjælper virksomheder med at kortlægge processer, vurdere data og integrationer og afprøve løsninger i lille skala, før der investeres i et større projekt. Læs om min AI-rådgivning her.
Kilder
- DCAI: Aftalen med Sevren (9. september 2026)
- Sevren: Lancering og de første resultater (26. august 2026)
- Sevren: Tekniske målinger for Heimr 570M (september 2026)
- Datatilsynet: Kunstig intelligens og databeskyttelse
- EDPB: Udtalelse om AI-modeller og GDPR
- EU's databeskyttelsesforordning
Skriv en kommentar
Har du en erfaring, et modargument eller et spørgsmål? Skriv endelig med. Din mailadresse bliver ikke offentliggjort.